

มติชน X BDI พัฒนา AI แห่งชาติ
“มติชน” ร่วม “BDI” นำข้อมูลคุณภาพสูงจากคลัง 50 ปี ร่วมการฝึกฝนพัฒนาโมเดล AI ภาษาไทย เร่งดัน ThaiLLM เป็นโมเดลพื้นฐานของชาติ หลัง BDI เผย อินเทอร์เน็ตทั่วโลกมีข้อมูลภาษาไทยแค่ 0.4% ทำให้ AI ระดับโลกไม่เข้าใจบริบทไทย เสี่ยงครอบงำโดยสถิติต่างชาติ ขณะที่ข้อมูลไทย 1 ใน 8 ไม่ได้ถูกสร้างโดยมนุษย์ หวังร่วมเสริมแกร่งระบบนิเวศ AI ไทย ลดพึ่งพาต่างชาติ เพิ่มแต้มต่อธุรกิจ SMEs-การศึกษา-ระบบราชการ ลดต้นทุน และสร้างกำลังคนด้านเทคโนโลยีในประเทศ
ท่ามกลางการเปลี่ยนผ่านสู่ยุคปัญญาประดิษฐ์ (AI) ที่คนไทยต้องพึ่งพาเทคโนโลยีส่วนใหญ่จากต่างชาติ ทั้งสหรัฐ และจีน เทคโนโลยีนี้กำลังทำให้เกิดช่องว่างในด้านความมั่นคงปลอดภัยของข้อมูล ความถูกต้องแม่นตรงของระบบภาษาและวัฒนธรรมที่จำเป็นยิ่งต่อระบบงานในระบบราชการ การศึกษา และสภาพแวดล้อมทางสังคมของไทย รวมถึงช่องว่างโอกาสในการเข้าถึงเทคโนโลยีโดยไม่ต้องเริ่มจากศูนย์ของประชาชนทั่วไป ธุรกิจในระยะเริ่มต้น และวงการศึกษา
ช่องว่างเหล่านี้ทำให้เรื่อง อธิปไตย AI หรือ AI Sovereignty กลายเป็นไฮไลต์หลักของโลก
ประเทศไทยมีความพยายามสร้าง AI Sovereignty ผ่านการวางรากฐานโมเดลภาษาขนาดใหญ่ภาษาไทย หรือ ThaiLLM นำโดย สถาบันข้อมูลขนาดใหญ่ (องค์การมหาชน) หรือ BDI และพันธมิตร
ศ.รด.ธีรณี อจลากุล ผู้อำนวยการ BDI กล่าวว่า ThaiLLM ไม่ได้เป็นการทำเพื่อแข่งขันกับโมเดลการค้าขนาดใหญ่ระดับโลก ด้วยงบประมาณและกำลังคนต่างกันมาก แต่มีเป้าหมายเพื่อสร้างทรัพยากรกลาง ทั้งชุดข้อมูล/Data, ชุดข้อสอบ/Benchmark, โค้ด และโมเดลพื้นฐาน เพื่อช่วยให้นักพัฒนา สตาร์ตอัพ และองค์กรไทย สามารถนำโมเดลไปปรับแต่ง ต่อยอดเป็นแอปพลิเคชั่นของตนเองได้สะดวก โดยไม่ต้องเริ่มพัฒนาใหม่จากศูนย์
อย่างไรก็ตามความท้าทายสำคัญในการวางรากฐานอธิปไตย AI ของชาตินี้ คือ ข้อมูลภาษาไทย บนระบบอินเทอร์เน็ต มีเพียง 0.4% และเป็นข้อมูลคุณภาพที่มนุษย์สร้างขึ้นแค่ 1 ใน 8 เท่านั้น
ในขณะที่ในปี 2570 นี้ มติชน จะก้าวเข้าสู่ปีที่ 50 ซึ่งได้สะสมข้อมูลคุณภาพท่ามกลางความเปลี่ยนแปลงของสังคม ครอบคลุมตั้งแต่ข่าวสาร ประวัติศาสตร์ ศิลปวัฒนธรรม และการเกษตร ผ่านกองบรรณาธิการที่เข้มงวดในการเขียนเรียบเรียงในระบบภาษาไทย ทำให้ ข้อมูล จากมติชนมีความสมบูรณ์พร้อมที่จะร่วมใช้ฝึกฝน AI ให้เข้าใจบริบทของภาษา ธรรมชาติของวัฒนธรรม
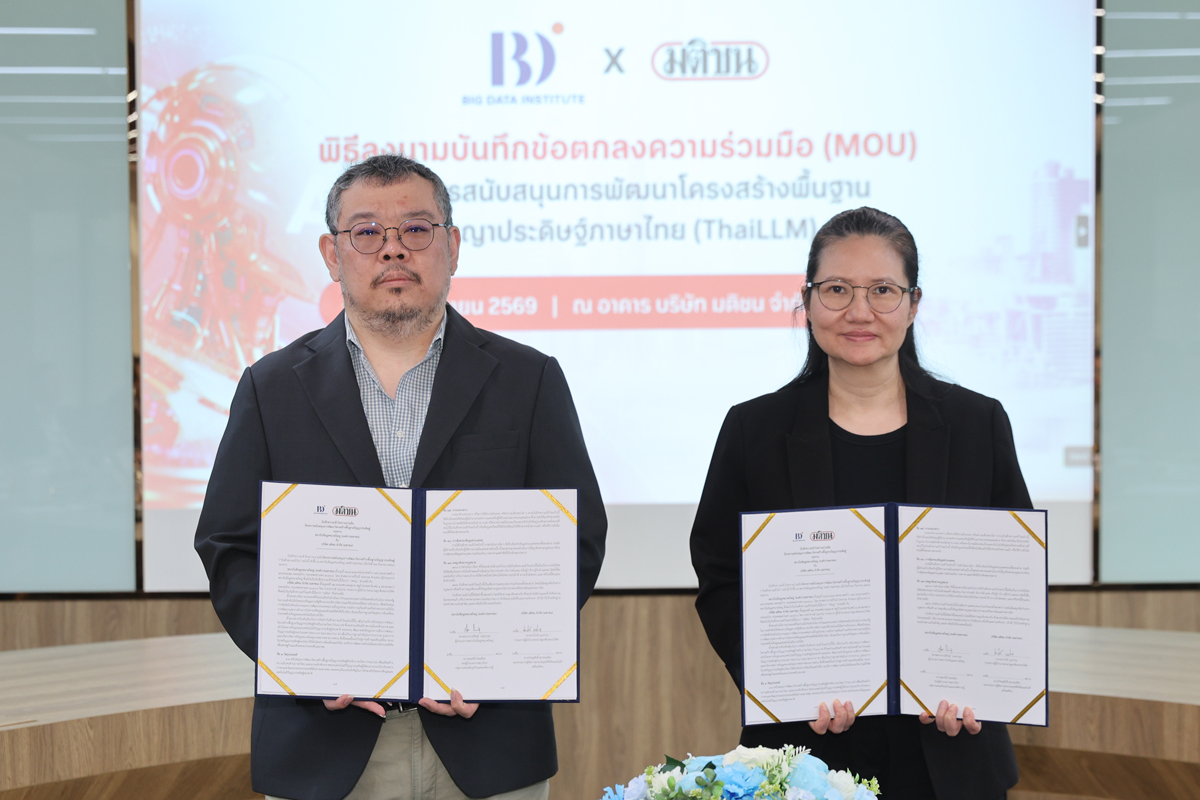
ดังนั้น ศ.ดร.ธีรณี อจลากุล ผู้อำนวยการสถาบัน BDI และนายปราปต์ บุนปาน กรรมการผู้จัดการ บริษัท มติชน จำกัด (มหาชน) จึงได้ร่วมลงนามบันทึกความเข้าใจความร่วมมือ (MOU) โครงการสนับสนุนการพัฒนาโครงสร้างพื้นฐานปัญญาประดิษฐ์ ความร่วมมือครั้งนี้มุ่งสนับสนุนการพัฒนาโครงสร้างพื้นฐานปัญญาประดิษฐ์สำหรับภาษาไทย หรือ Thai Large Language Model (ThaiLLM) และคลังข้อมูลกลางเพื่อการพัฒนาปัญญาประดิษฐ์ของประเทศ (National Data Bank for AI) โดยนำศักยภาพด้านข้อมูลภาษาไทยคุณภาพสูงจากฐานข้อมูลในเครือมติชนมาสนับสนุนการพัฒนา AI ที่เข้าใจภาษา วัฒนธรรม และบริบทของประเทศไทย เสริมความแข็งแกร่งให้ระบบนิเวศ AI ของไทย และวางรากฐานสู่อธิปไตยทางปัญญาประดิษฐ์
มติชน สู่ ThaiLLM
ปราบต์ บุนปาน กล่าวว่า ในยุคที่ปัญญาประดิษฐ์ (AI) เข้ามามีบทบาทต่อการทำงานและการใช้ชีวิตมากขึ้น ข้อมูลคุณภาพ คือรากฐานสำคัญของเทคโนโลยีที่มีคุณภาพ ตลอดระยะเวลาการทำงานด้านข่าวและเนื้อหาที่มีมาอย่างยาวนาน มติชนได้สั่งสมข้อมูลที่ให้ความสำคัญกับความถูกต้อง ความน่าเชื่อถือ ความร่วมมือในครั้งนี้เราจึงให้การสนับสนุนด้านข้อมูลที่ถูกต้องและน่าเชื่อถือจากฐานข้อมูลของสื่อต่าง ๆ ในเครือ เพื่อสนับสนุนการพัฒนาปัญญาประดิษฐ์ภาษาไทยให้มีความเข้มแข็งและมีประสิทธิภาพ ครอบคลุมองค์ความรู้และบริบทในมิติต่าง ๆ ได้อย่างรอบด้านมากยิ่งขึ้น
“ในปี 2570 นี้มติชนจะก้าวเข้าสู่ปีที่ 50 เครือมติชน ได้แก่ มติชน ข่าวสด ประชาชาติธุรกิจ มติชนสุดสัปดาห์ เทคโนโลยีชาวบ้าน เส้นทางเศรษฐี และศิลปวัฒนธรรม ยังคงทำหน้าที่ผลิตและรวบรวมข้อมูลข่าวสารภาษาไทยที่สะท้อนประวัติศาสตร์ ทั้งเหตุการณ์ ความเปลี่ยนแปลง และบริบทของสังคมไทยในหลากหลายมิติ โดยยังคงบทบาทของการเป็นสื่อที่นำเสนอความจริงและองค์ความรู้เพื่อสังคมไทยมาอย่างต่อเนื่อง ที่สำคัญคือเรามีฐานข้อมูล เนื้อหา และองค์ความรู้ที่มีคุณภาพ น่าเชื่อถือ
ดังนั้น การร่วมมือระหว่าง มติชน และ สถาบันข้อมูลขนาดใหญ่ หรือ BDI จึงเป็นโอกาสสำคัญในการนำทรัพยากรข้อมูลที่มีคุณภาพมาต่อยอดให้เกิดประโยชน์ในมิติใหม่ โดยเฉพาะการสนับสนุนการพัฒนา ThaiLLM ให้สามารถเข้าใจภาษา เนื้อหา และบริบทของสังคมไทยได้อย่างลึกซึ้งยิ่งขึ้น พร้อมเป็นส่วนหนึ่งของการสร้างโครงสร้างพื้นฐานด้านปัญญาประดิษฐ์ที่คนไทยสามารถนำไปใช้และพัฒนาต่อยอดได้จริง
ขณะเดียวกัน ความเชี่ยวชาญในการเรียบเรียงและใช้ภาษาไทยในแบบกองบรรณาธิการข่าวก็เป็นองค์ความรู้สำคัญที่สามารถนำมาต่อยอดสู่การพัฒนา AI ให้เข้าใจบริบทและการสื่อสารภาษาไทยได้อย่างมีคุณภาพ
การนำองค์ความรู้และข้อมูลภาษาไทยที่มติชนสั่งสมมาตลอด 50 ปี มาผสานกับศักยภาพด้านข้อมูลและเทคโนโลยีของ BDI จึงไม่ใช่เพียงการสนับสนุนการพัฒนาโมเดล AI แต่คือการร่วมสร้าง โครงสร้างพื้นฐานความรู้ภาษาไทยสำหรับอนาคต ที่ช่วยให้เทคโนโลยีเข้าใจบริบทของสังคมไทยได้ดียิ่งขึ้น รวมทั้งสามารถต่อยอดให้เกิดประโยชน์แก่ภาคธุรกิจ นักพัฒนา สังคม และประเทศได้อย่างยั่งยืน
ฝ่าความท้าทาย AI ของชาติ
ด้าน ศ.ดร.ธีรณี กล่าวว่า ข้อมูลภาษาไทยบนอินเทอร์เน็ตมีสัดส่วนน้อยมาก ไม่ถึง 0.4% ทำให้โมเดลระดับโลกถูกครอบงำด้วยข้อมูลภาษาต่างชาติ และมักตอบคำถามด้วยบริบทของต่างชาติ ขณะที่ข้อมูลภาษาไทยคุณภาพสูงที่สกัดจากมนุษย์จริง ๆ มีสัดส่วนเพียง 1 ใน 8 หรือ 1 ใน 9 ของข้อมูลภาษาไทยทั้งหมดที่มี
เราอาจพูดได้ว่าโมเดลประเภทแชตบอตเลือกตอบคำถามตามสัดส่วนข้อมูล มักจะเลือกข้อมูลที่มีมากกว่ามาตอบเสมอ หากใช้โมเดลระดับโลกโดยตรงโมเดลจะถูกครอบงำด้วยสถิติข้อมูลต่างชาติ ทำให้ตอบคำถามด้วยบริบท ค่านิยม หรือกฎหมายของต่างประเทศ ซึ่งไม่ตรงกับความเป็นจริงในประเทศไทย จึงจำเป็นต่อการฝึกฝน AI ให้ประมวลผลข้อมูลให้ถูกต้องตรงตามบริบทของไทย
ปัจจุบัน BDI ได้เริ่มเปิดโมเดลต้นแบบให้ทดลองใช้ในขนาดเล็กถึงปานกลาง เหมาะกับข้อมูลที่มีความละเอียดอ่อนสูง เช่น ข้อมูลการแพทย์ ที่ทางโรงพยาบาลศิริราช มหาวิทยาลัยมหิดล เริ่มนำไปทดสอบแล้ว และยังช่วยสนับสนุนการปฏิรูปและปรับปรุงการทำงานของภาครัฐ การประมวลผลเอกสาร กฎหมาย ซึ่งเป็นบริบทที่เฉพาะเจาะจงมาก ด้วยกฎหมายไทยที่เป็นเรื่องเดียวกันกระจายอยู่ในตัวบทหลายฉบับ ในตอนนี้เริ่มใช้ในกระบวนการรับฟังความเห็น และปรับปรุงกฎหมายโรงแรม
ในอนาคตจะเริ่มการฝึกฝนโมเดลสำหรับภาพและวิดีโอ รวมถึงการประมวลผล ภาษาถิ่น ทั้งข้อมูลข้อความและเสียง เพื่อให้คนไทยในทุกภูมิภาคใช้งานเทคโนโลยีได้